
En 2010, l’ICTD a entrepris de constituer le Government Revenue Dataset (GRD) de l’ICTD, de plus en plus reconnu comme la meilleure source possible de données comparées sur les recettes publiques pour les chercheurs. L’une des motivations principales tenait à la qualité et à la transparence des données disponibles auprès du FMI : les données publiques présentaient d’importantes limites, tandis que les données privées utilisées dans une grande partie des travaux du FMI n’étaient pas accessibles aux autres chercheurs et semblaient comporter des erreurs significatives.
L’objectif immédiat du GRD était donc de fournir aux chercheurs des données de meilleure qualité et plus transparentes. Il a été atteint avec le lancement des données en septembre 2014. L’objectif de plus long terme est d’inciter les organisations internationales, FMI en tête, à investir dans des données de meilleure qualité et à les rendre publiques. Des avancées importantes ont eu lieu récemment, la dernière étant celle du FMI, qui a publié en août le jeu de données World Revenue Longitudinal Data (WoRLD), rendant publiques les données de recettes utilisées en interne par ses chercheurs – ce que l’ICTD et d’autres réclamaient de longue date. Le jeu WoRLD emploie une méthodologie proche de celle du GRD, en fusionnant des données de plusieurs sources internationales afin d’améliorer la couverture. Sa publication marque une étape importante et nécessaire vers davantage de transparence.
Cependant, comme nous l’exposons ci-dessous, le GRD demeure une source nettement plus complète et de meilleure qualité pour la plupart des chercheurs. Cette brève note résume les principales différences entre les deux jeux de données et les avantages notables du GRD.
Sources et couverture
Le WoRLD du FMI s’appuie exclusivement sur les données des Perspectives de l’économie mondiale du FMI (WEO), des Statistiques de finances publiques du FMI (GFS), des Statistiques des recettes publiques de l’OCDE et de leur déclinaison pour l’Amérique latine. À noter : les données fiscales du WEO ne sont pas elles-mêmes publiques ; à ce titre, elles ne sont pas retenues pour le GRD. À l’inverse, l’ICTD utilise toutes les mêmes sources, à l’exception du WEO, mais mobilise aussi les rapports au titre de l’article IV du FMI et les données de la CEPALC (Comisión Económica para América Latina y el Caribe) pour l’Amérique latine.
L’intégration des données des rapports article IV dans le GRD s’est révélée particulièrement complexe : il a fallu les extraire manuellement des rapports d’origine, et la catégorisation incohérente de ces rapports a exigé un soin extrême lors de la fusion. Les bénéfices de cet effort sont toutefois considérables, puisque ces données permettent au GRD d’atteindre une couverture nettement supérieure à celle du WoRLD. C’est ce qu’illustre le tableau 1, qui montre une meilleure couverture pour chaque sous-catégorie de recettes et d’impôts dans le GRD entre 1990 et 2013.¹²
Fusion, nettoyage et exactitude des données
Une différence plus importante tient à la méthode de fusion des données issues de plusieurs sources. Le WoRLD repose sur un algorithme de fusion automatique, qui combine les sources selon, pour l’heure du moins, une hiérarchie stricte de préférences :
- pour tous les pays, le total des recettes est tiré du WEO ;
- pour les pays de l’OCDE et d’Amérique latine, toutes les données fiscales proviennent des Statistiques des recettes publiques de l’OCDE ;
- pour tous les autres pays, le total des recettes fiscales vient du WEO, et les sous-catégories des GFS ;
- les GFS comportant plusieurs séries, les données des administrations publiques sont préférées, celles de l’État central ou du budget de l’État central étant retenues à défaut.
En principe, un tel algorithme est très séduisant : il est rapide et objectif. En pratique, cependant, il ne produit des données pleinement valides que si les données brutes des différentes sources internationales sont mutuellement compatibles. Cette hypothèse ne tient malheureusement pas, ce qui crée des ruptures problématiques dans les séries, exigeant un nettoyage manuel par l’utilisateur et réduisant encore la couverture.
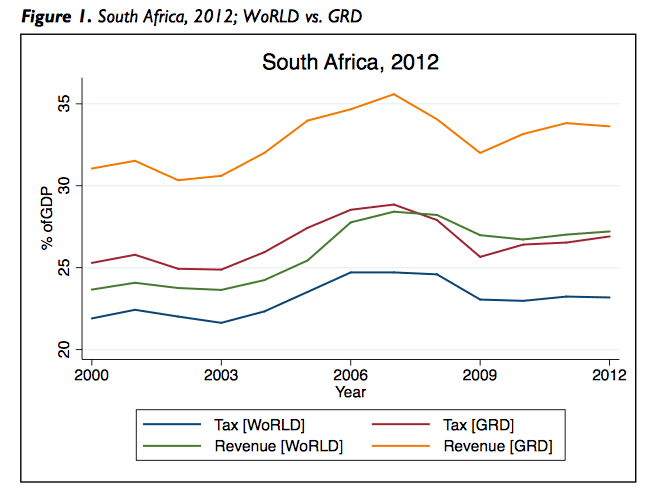
La figure 1, qui présente le total des recettes et le total des impôts pour l’Afrique du Sud en 2012, montre que les chiffres du WEO (utilisés dans le WoRLD) ne correspondent souvent pas à ceux des GFS (utilisés dans le GRD) : fusionner ces deux sources pour une même année-pays peut donc induire en erreur. Ici, les données du WEO sont nettement inférieures à celles des GFS, et l’on ne voit pas clairement pourquoi les données fiscales du WEO sont préférées à celles des GFS, qui rapportent pourtant les deux de manière très cohérente.³
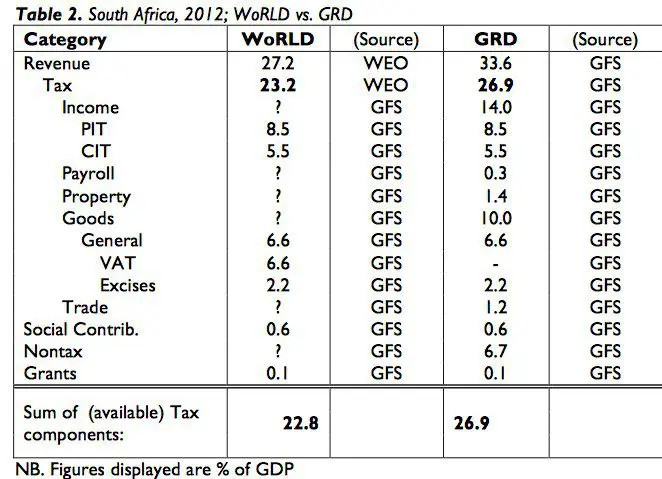
Le tableau 2 examine ce cas de plus près et met encore en évidence les problèmes que pose l’usage de deux sources différentes pour une même année-pays. Le GRD (à droite) tire toutes ses données des GFS, si bien que la somme des sous-composantes égale le total des recettes fiscales. Il n’en va pas de même pour le WoRLD : nous ne pouvons espérer comprendre comment le total du WEO a été calculé sans le détail de chaque sous-composante.
Ce n’est bien sûr qu’un exemple et, s’il existe un bon nombre de cas où les chiffres du WEO et des GFS coïncident presque exactement, il semble plus fréquent que les deux sources divergent. Pour le sous-ensemble d’observations année-pays où les deux jeux comportaient un chiffre, l’écart moyen sur le total des recettes atteignait 3,4 % du PIB.
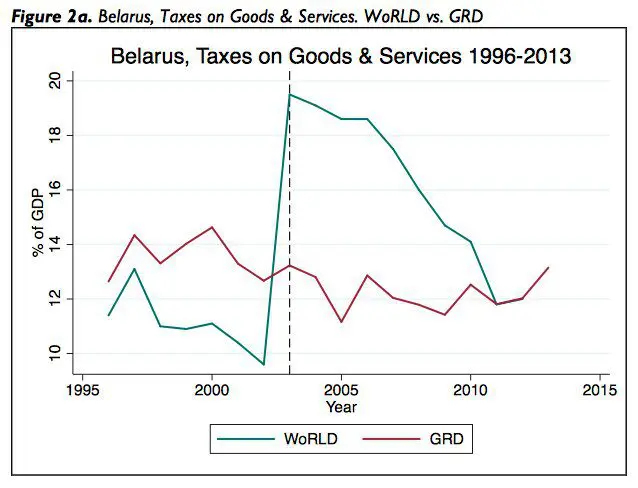
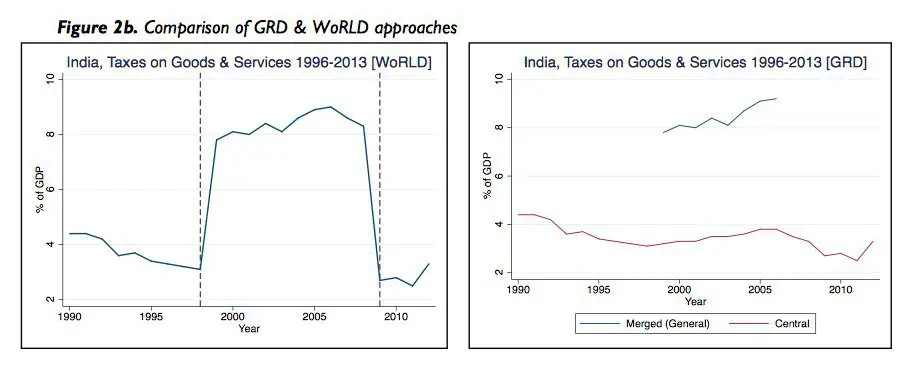
Les figures 2a et 2b illustrent un problème plus large, où les données des GFS passent de l’État central aux administrations publiques, créant là encore une rupture trompeuse. Le changement de source donne l’apparence d’une variation majeure de la collecte, alors qu’aucune n’a eu lieu. L’exemple de la figure 2a porte sur les impôts sur les biens et services au Bélarus. Le GRD utilise les données article IV jusqu’en 2011, puis bascule sans heurt sur les GFS, d’où une série assez cohérente. Le WoRLD, lui, utilise les GFS d’un bout à l’autre. En 2003 (repéré sur la figure), il passe du central aux administrations publiques, et le problème saute aux yeux : suggérer une hausse de plus de 100 % des impôts sur les biens et services n’est pas seulement parfaitement invraisemblable, cela emporte aussi de lourdes conséquences pour tout travail économétrique qui voudrait utiliser ces données.
Deuxièmement, et plus curieusement, les données fiscales du WEO largement utilisées dans le WoRLD ne sont pas accessibles publiquement via le WEO. Les créateurs du WoRLD méritent d’être félicités de les avoir rendues publiques pour la première fois, mais il serait préférable encore d’avoir accès à la source d’origine et aux informations entourant sa construction.
En résumé
Malgré ces faiblesses, le WoRLD occupe une place propre : c’est une tentative de construire un jeu de données composite à partir des principales bases internationales, de manière transparente, entièrement automatisée et sans part discrétionnaire. Il a permis de rendre publiques, pour la première fois, les données fiscales du WEO. Utilisé avec précaution, il peut servir à produire des tendances nationales, régionales et mondiales sur la collecte des recettes, et à certains types limités d’analyse économétrique.
Il comporte toutefois des limites très importantes. Les données ne seront vraiment fiables, pour quelque analyse que ce soit, que si les chercheurs traitent avec soin le cas des États producteurs de ressources et nettoient soigneusement, et manuellement, les ruptures et les erreurs existantes. Même alors, l’absence de traitement de la question des recettes issues des ressources, jointe aux données manquantes, impose de fortes limites. L’absence de documentation et de repères clairs fait par ailleurs courir un risque considérable de mauvais usage.
Ainsi, le GRD reste, et de loin, la meilleure ressource disponible pour presque tous les types de recherche et d’analyse sur l’impôt et les recettes. La fusion et le nettoyage manuels qui le sous-tendent comportent naturellement des risques, et les données sur les recettes issues des ressources restent imparfaites. Mais traiter imparfaitement les faiblesses des données internationales demeure bien préférable à toute autre solution. La transparence constante du GRD et son adoption de plus en plus large ont confirmé, de façon inestimable, sa qualité et son exactitude d’ensemble.
Cela dit, la coopération garde une large marge de progression. À long terme, le FMI reste le mieux placé pour collecter des données de recettes publiques de grande qualité. Surtout, il existe un besoin urgent de données de qualité et publiques sur les recettes tirées des ressources naturelles. La publication du WoRLD semble marquer un engagement accru en faveur des données de recherche et de leur transparence, et n’est, espérons-le, qu’une première étape.
La figure 2b offre un autre type d’exemple. Il porte là encore sur les impôts sur les biens et services, cette fois pour l’Inde. Le panneau de gauche montre l’approche du WoRLD, avec un bond abrupt puis une chute sur les années 1998-2009, où les données des administrations publiques sont utilisées. Le GRD propose ici deux solutions. Son jeu « fusionné » (où les administrations publiques sont généralement préférées, si elles sont disponibles) ne retient que les années pour lesquelles ces données existent. Sinon, un jeu « central » distinct est disponible, avec une série cohérente pour l’État central. Les deux options du GRD évitent le bond massif que produit le WoRLD du fait de sa fusion automatisée.
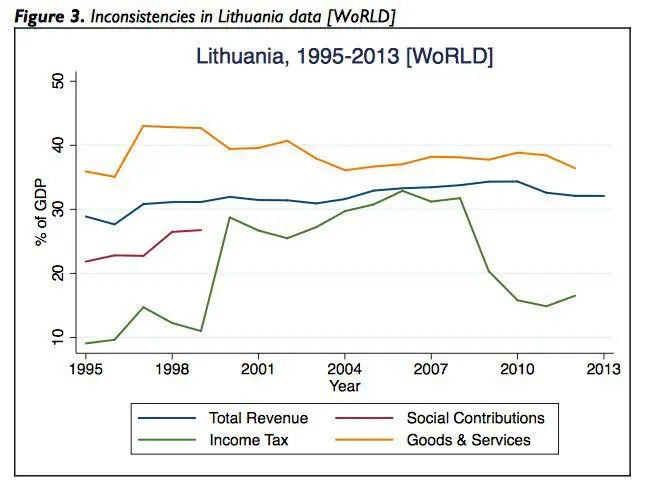
Enfin, la figure 3 illustre le problème le plus important et le plus simple : dans quelques cas, la donnée saisie est tout bonnement fausse, et l’absence de nettoyage manuel minutieux a laissé l’erreur subsister. Les chiffres de la Lituanie font apparaître, entre autres erreurs, des impôts sur les biens et services supérieurs au total des recettes. De tels problèmes ne sont pas rares pour un jeu de données nouveau et seront sans doute corrigés aux prochaines mises à jour. Mais leur existence souligne l’importance de la transparence pour débusquer les erreurs.
Quelle solution le GRD apporte-t-il à ces problèmes ? Trois éléments clés.
1) Il retient une source unique pour chaque combinaison pays-année, ce qui réduit les incompatibilités possibles entre le total des recettes, le total des impôts et les chiffres plus désagrégés.
2) La fusion des données du GRD a été faite manuellement, chaque point étant examiné au moins deux fois, afin de repérer les données intrinsèquement problématiques comme les discontinuités entre sources.
3) C’est cette approche qui permet au GRD d’exploiter les rapports article IV du FMI, tous saisis manuellement.
Avec des sources sous-jacentes imparfaites, le nettoyage manuel est absolument indispensable à la qualité des données, et seul le GRD a mené ce travail de manière complète et transparente pour tous les pays. Les exemples ci-dessus montrent que, sans ce soin et cette attention, des incohérences et des problèmes majeurs peuvent subsister.
Les recettes non fiscales
Le WoRLD se caractérise aussi par une omission importante : il ne comporte pas de catégorie pour le total des recettes non fiscales. Sur le plan conceptuel, c’est potentiellement problématique : comprendre la réalité budgétaire d’un pays suppose de connaître toutes ses sources de recettes, susceptibles de s’influencer mutuellement. De manière évidente, l’accès à des recettes non fiscales influe sur le niveau d’impôt que l’on choisit de lever. Des études récentes ont montré qu’il est indispensable d’inclure une mesure du total des recettes non fiscales dans toute analyse économétrique cherchant à expliquer la collecte fiscale totale. Or l’absence d’une telle variable dans le WoRLD rend la chose impossible.
Intuitivement, la difficulté devrait être facile à contourner : soustraire du total des recettes les impôts, les dons et les cotisations sociales devrait normalement laisser le total des recettes non fiscales. Mais cette opération simple n’est strictement valide que si tous les chiffres proviennent de la même source, ou de sources mutuellement compatibles. Comme on l’a vu, ce n’est pas toujours le cas dans le WoRLD. Lorsque le total des recettes vient du WEO et les variables fiscales d’une autre source, le risque d’inexactitude est important si l’on calcule simplement les recettes non fiscales par différence. La valeur obtenue peut refléter fidèlement les recettes non fiscales, mais tout aussi bien les écarts entre les deux sources, et fausser l’analyse.
Les recettes tirées des ressources naturelles
Préoccupation étroitement liée, et sans doute la différence la plus importante entre les deux jeux de données : le GRD s’attache systématiquement à distinguer les recettes tirées des ressources naturelles (pétrole, mines) de toutes les autres recettes fiscales – principalement grâce aux rapports article IV du FMI – ce que le WoRLD ne fait pas. Les conséquences sont parfois majeures, car les sources internationales ne s’accordent pas sur le classement de ces recettes en fiscales ou non fiscales pour les grands pays producteurs. Ce classement est souvent exact d’un point de vue strictement comptable, mais il peut produire des données très trompeuses à des fins d’analyse.
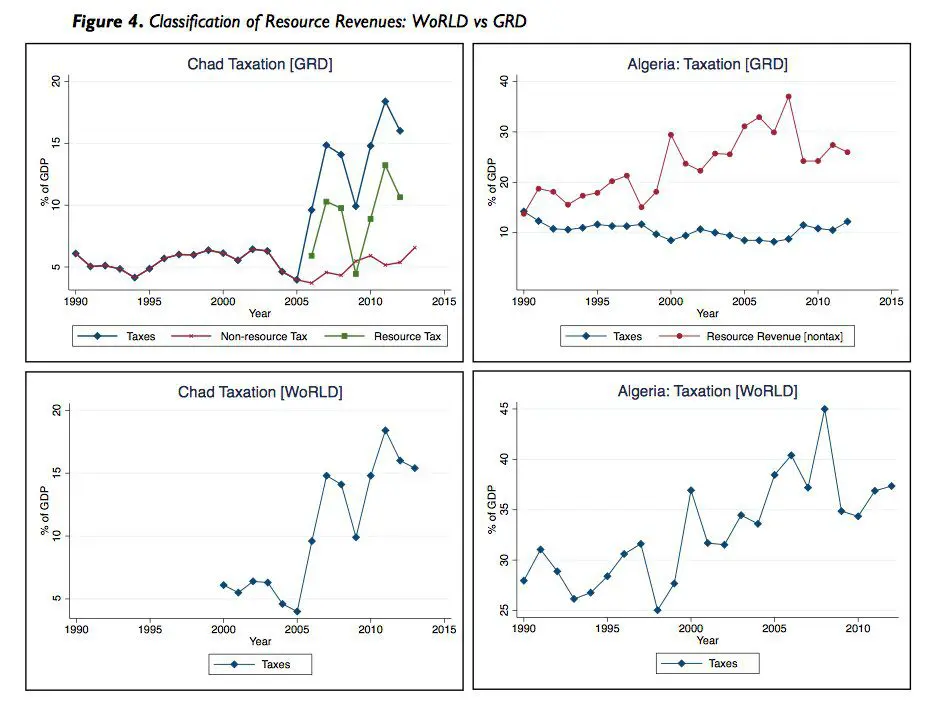
Dans le WoRLD, certains grands producteurs de pétrole figurent parmi les pays qui lèvent le plus d’impôts au monde (l’Angola, l’Algérie), tandis que d’autres affichent une collecte exceptionnellement faible assortie de recettes non fiscales très élevées (Bahreïn, Irak). Pour bien d’autres pays, la collecte varie fortement selon la façon dont les recettes
tirées des ressources sont classées. Cela invalide probablement tout travail économétrique utilisant l’intégralité des données WoRLD. L’hétérogénéité de traitement entre pays implique une erreur de mesure considérable. Or les chercheurs s’intéressent généralement soit aux recettes fiscales hors ressources, soit aux recettes tirées des ressources, et les données du FMI empêchent une distinction claire et cohérente.
L’approche adoptée par l’ICTD est double. D’abord, lorsque c’est possible, il distingue les composantes liées et non liées aux ressources, tant pour les recettes fiscales que non fiscales. Les utilisateurs peuvent ainsi mesurer la collecte totale telle que l’enregistrent les sources internationales, mais aussi, plus important, les recettes fiscales hors ressources, cohérentes d’un pays à l’autre et généralement au cœur de l’intérêt des chercheurs. Ensuite, lorsque c’est nécessaire, l’ICTD retient une solution de second rang : n’inscrire dans les catégories fiscales que les recettes hors ressources, et classer toutes les recettes de ressources en recettes non fiscales. Ce n’est pas strictement exact sur le plan comptable mais, de façon décisive, c’est bien plus juste analytiquement pour la plupart des travaux, puisque cela permet une comparaison cohérente des recettes fiscales hors ressources entre pays.
Le résultat n’est donc pas parfait – et reste limité par la qualité des données des rapports-pays du FMI – mais il paraît nettement préférable à l’absence de traitement. La figure 4 en donne deux exemples. Pour le Tchad, qui déclare pour la première fois des recettes fiscales de ressources en 2006, on observe un bond important du chiffre WoRLD. Le GRD, lui, parvient à isoler ces recettes du total et à fournir une série hors ressources cohérente. L’Algérie illustre une autre manifestation du problème : les recettes de ressources y sont traitées comme fiscales dans le WoRLD, mais comme non fiscales dans le GRD. Les chiffres algériens apparaissent donc fortement gonflés et volatils, alors que cela tient presque exclusivement aux hydrocarbures. L’ICTD parvient à l’inverse à construire une série hors ressources, plus cohérente et plus crédible dans le temps pour la plupart des usages de recherche.
Une documentation plus claire
Un objectif clé du GRD a été d’assurer un haut degré de transparence et de documentation sur la construction et l’usage des données. Chaque point est rattaché à une source précise, tous les choix sont soigneusement documentés, les données potentiellement problématiques sont explicitement signalées, et un document de travail détaillé a été publié avec le jeu de données, avec une discussion des limites et des usages appropriés.
À certains égards, le WoRLD suit la même voie, ce qui est tout à son honneur. Chaque point est explicitement rattaché à sa source, ce qui permet aux utilisateurs d’en comprendre l’origine et de repérer d’éventuels problèmes. Et si la fusion automatisée comporte d’importantes faiblesses, elle garantit au moins la transparence des choix opérés.
Deux préoccupations majeures subsistent toutefois. D’abord, les créateurs du jeu de données n’ont pas encore publié de document de travail ni de guide d’utilisation. Un tel document devrait surtout décrire en toute transparence les limites des données – celles exposées ici – et préciser les usages possibles, comme ceux qui ne le sont pas. Sans ces repères, le risque paraît très élevé que les chercheurs téléchargent simplement les données sans recul, sans tenir compte des limites décrites ici. Il en résulterait des résultats trompeurs.
1 À noter, le GRD offre aussi une très bonne couverture dès 1980 (même si, par souci de comparabilité, cela n’apparaît pas dans le tableau 1).
2 NB : toutes les sous-catégories ne peuvent pas atteindre 100 % de couverture (tous les pays n’ont pas, par exemple, de taxe sur les salaires ou d’impôt foncier).
3 Un problème semblable tient à ce que le WoRLD ne publie pas le total des recettes hors dons (et, de fait, à ce que le chiffre des dons provienne d’une autre source). Le total des recettes indiqué est donc potentiellement problématique, car les dons, dont l’enregistrement varie énormément d’un pays à l’autre, peuvent être extrêmement volatils et sont donc presque certainement trompeurs par moments.