Les pays en développement manquent souvent des ressources financières nécessaires pour fournir des biens publics. L’impôt foncier a été identifié comme une source prometteuse de recettes locales, car il est relativement efficient, capte la croissance de la valeur immobilière et peut être progressif. De nombreux pays à faible revenu ne le recouvrent toutefois pas efficacement, faute de rôles d’impôt foncier complets, voire existants.
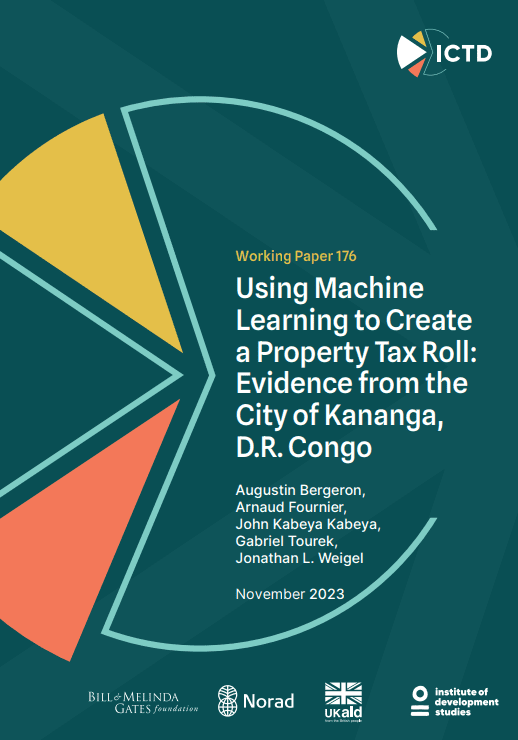
Nous recourons à des modèles d’apprentissage automatique et de vision par ordinateur pour constituer un rôle d’impôt foncier dans une grande ville congolaise. Pour entraîner l’algorithme et prédire la valeur de tous les biens de la ville, nous nous appuyons sur la valeur de 1 654 propriétés choisies au hasard et évaluées par des géomètres de l’État lors de visites d’expertise sur place, ainsi que sur des caractéristiques issues des données administratives ou extraites de photographies des biens. Le meilleur algorithme d’apprentissage automatique, entraîné sur les caractéristiques issues des données administratives, atteint un R2 validé par validation croisée de 60 pour cent, et 22 pour cent des valeurs prédites se situent à moins de 20 pour cent de la valeur cible. Les algorithmes de vision par ordinateur, entraînés sur les caractéristiques des photographies, obtiennent de moins bons résultats : seules 9 pour cent des valeurs prédites se situent à moins de 20 pour cent de la valeur cible pour le meilleur algorithme.
Nous interprétons ces résultats comme suggérant que des méthodes simples d’apprentissage automatique peuvent servir à constituer un rôle d’impôt foncier, même là où l’information sur les biens est limitée et où l’administration ne peut recueillir qu’un petit nombre de valeurs par des visites d’expertise sur place.